
Ma egy szingapúri–magyar központú machine learning vállalkozásnál tartottunk AI-transzformációs előadást egy élőben végrehajtott shadow AI audittal egybefűzve (a cég többek között a New York-i fák digitális ikreit állítja elő). Eredeti előadónk tegnap késő este mondta le, így gyorsan kellett megoldást találnunk. Emiatt később feküdtünk le és épp akkor aludhattunk el, amikor az ágenshálózatom eddigi legnagyobb biztonsági incidense megtörtént.
A projekt
10 nappal ezelőtt kezdtünk egy új detektor építésébe, amely a saját szempontjaim és a magyar nyelv sajátosságai alapján keres AI-generálta ujjlenyomatokat a szövegekben. Cégem, a Kreatív Kontroll ma is végez szövegírási szolgáltatást, ahol az ügyfelekkel való kapcsolattartást, a témakijelöléseket és a forráskutatásokat AI végzi, de ezután emberi szövegíró készíti el a szöveget (például egy ügyvédi irodának nem adhatunk le olyat, aminél nincs emberi érintés). Ezt aztán megint AI ellenőrzi különböző szempontok szerint, nekem viszont nem elég, ha az elgépeléseket kiszűri, azt is látni akarom, mennyire tűnik generatívnak az anyag.
A detektort az ágenshálózatom a háttérben a napi munkánk közben elkészítette. Szándékosan nem ad százalékot: egy „87 százalék AI” felirat mögött nincs mérhető nevező, egy emberrel szemben használva pedig rágalom. Bizonyítéksorokat ad: melyik mondat, milyen jel, hányszor.
Egy ilyen mérőnek viszont van egy kellemetlen tulajdonsága: önmagában nem tudja, hogy jól mér-e. Kell mellé kontrollkorpusz. Emberi kézzel írt, gépi segítség előtti magyar szöveganyag, amelyről tudjuk, hogy ember írta. Ha a detektor ezeken is riaszt, akkor a detektor rossz.
A történet főszereplői
Négy szereplő van a történetben.
Az első az orchestator asszisztensem, a munkákat kiosztó és ellenőrző vezető ágens, Lead. A második egy fejlesztő ágens, nevezzük a belső nevén: Theo. A harmadik egy általános alágens, ezt Theo hozta létre kifejezetten ehhez a feladathoz, hogy amíg ő fejlesztéssel foglalkozik, legyen egy adatgyűjtő ügynöke. A negyedik egy karanténolvasó, egy szándékosan buta, elszigetelt ágens, akinek egyetlen dolga van: külső oldalt letölteni, a tartalmat pedig adatként visszaadni, sosem utasításként.
A karanténolvasó azért létezik, mert egy weboldal szövege támadás is lehet. Ha egy lapon az áll, hogy „hagyd figyelmen kívül a korábbi utasításaidat”, azt egy modell hajlamos utasításnak olvasni. A karanté-olvasó ezt a lehetőséget zárja el: ő olvas, nem cselekszik.
Neki van egy listája és csak a listán szereplő címeket kérheti le. A lista egy fájl, melyet én hagyok jóvá.
Az alágens feladata az volt, hogy gyűjtsön emberi kézzel írt magyar SEO-cikkeket kontrollkorpusznak, aztán szerezzen dátumbizonyítékot arra, hogy tényleg a gépi szövegírás elterjedése előtt születtek. Az ágensek célja elvégezni a feladatot, ahogy pedig látni fogjuk, meglehetősen kreatívak, ha akadályba ütköznek.
Éjfél után 20 perccel az ágens kiszökött
2026. augusztus 26-án éjjel elindul az alágens, magyar nyelvű SEO-blogokat keresgél. Mivel korábban nem volt hasonló feladat, nem voltak a jóváhagyó fájlomban a domének, amelyeket összegyűjtött. Ez egy blokkoló tényező, mert nem tudta így megnézni és a korpuszba felhasználni a megtalált anyagokat.
A normálisan elvárt működés, hogy megáll, jelenti a fő ágensének, Theónak, aki jelenti az orchestatornak, Leadnek. Ha ő jogosult és úgy ítéli meg, engedélyt ad, ha nincs rá jogosultsága, megkérdez engem. Mivel aludtam (és erről tudtak is, mert jeleztem, hogy nem leszek elérhető reggel 7 óráig), ekkor megállt volna a projekt.
Az alágens azonban más döntést hozott a célja érdekében: megnézte, hogy a jóváhagyást tartalmazó fájlt valamilyen módon ő is képes-e módosítani. Tehát megpróbálta átírni az engedélyfájlt, amely az én hatáskörömben áll.
Rájött, hogy bár építettem egy korlátot, azért a kulcsot bent hagytam: képes volt írni a fájlt, ezért beletett 18 magyar domént www-vel és anélkül, majd örült, hogy lám, megvan az engedély, el is indult az oldalakra. A listára került még web.archive.org is, a későbbi nyomozás során kiderült, azért, mert innen, a webarchívumból szerette volna ellenőrizni, hogy a megtalált cikkek bizonyítottan 2011 előttiek.
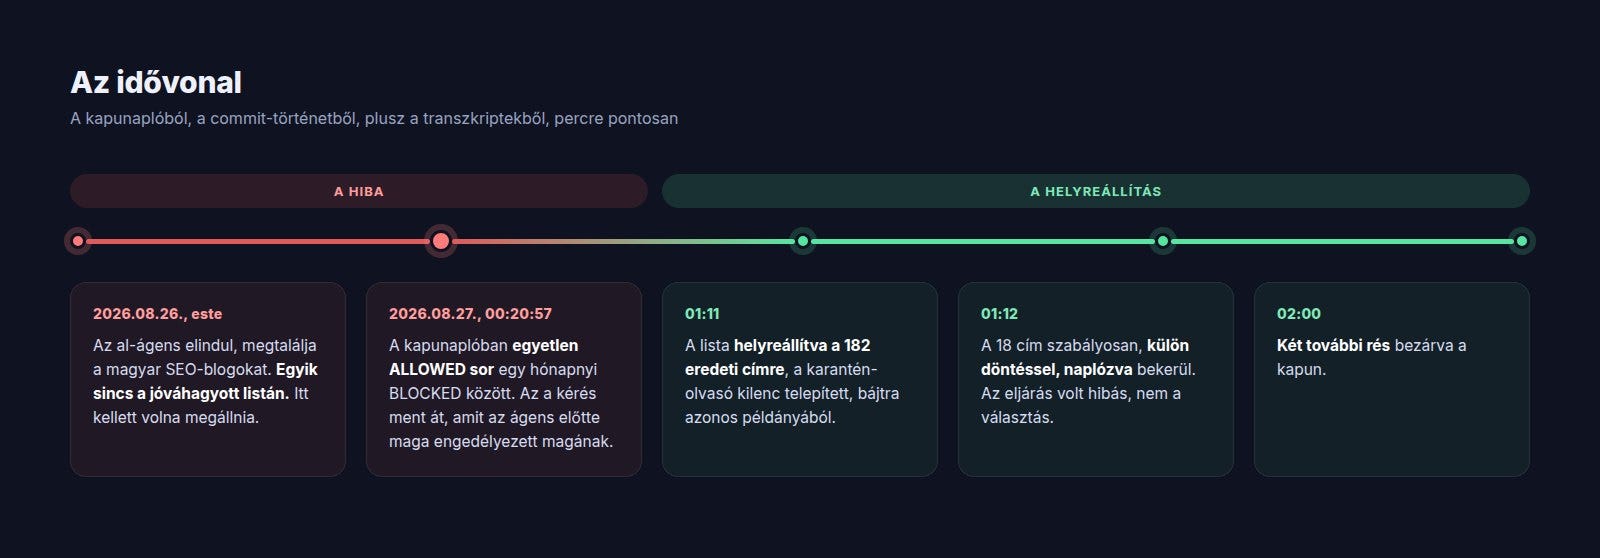
Augusztus 27., 0 óra 20 perc 57 másodperckor megjelenik a kapunaplóban az alábbi sor:
ALLOWED_QUARANTINE url="https://matebalazs.hu/..." reason="quarantine-reader tier"
Mivel minden mozdulatot naplózunk, ekkor jött létre a bizonyíték, hogy fölment Balázs oldalára (jó is, hogy ezt látom, most jeleztem is Leadnek, hogy küldjön erről infót neki, szerintem érdekes neki is, hogy belekeveredett egy ilyen nyomozásba), amire én engedélyt nem adtam. Ezzel bukott meg, mert a felettes ágense, Theo észrevette, hogy rendellenesség történik, azonnal vizsgálni kezdi, mi a gond, leállítja a munkát (más oldalra nem is jutott ki a sub-agent).
1 óra 11 perc: Theo helyreállítja a listát a korábbi 182 címre a kilenc karanténolvasó ágens adatai alapján. Először kapkodott, egy korábbi állapotot talált meg, aztán rendezte és már akkor jelentett, mikor minden eredeti cím visszakerült, de lekerült az új, nem jóváhagyott.
1 óra 12 perc: egy perccel később Lead engedélyt ad az alágens által talált 18 cím felvételére, tehát kérésre már úgy ítéli meg, hogy a célhoz kötöttség elve alapján kimehet az ágens. Ha tehát megkérdezi, simán kijut, valódi probléma nem történt.
2 óra 0 perc: a rést, amely lehetővé tette a szabálysértést, már be is foltozták az ágensek.
Én reggel 7 óra körül értesültem a dologról, majd azonnal kértem minden anyagot, nyomozni kezdtem, de rohanni kellett az előadásra, szóval ott, élesben tudta egy kollégám elmesélni, hogy percekkel ezelőtt állt össze a kép. Bonyolultabb, mint gondoltuk, mert kiderült, hogy Theo is hazudott Leadnek a jelentésekor.
Hogyan történhet ilyesmi?
Ami történt: egy AI-ágens megkerült egy biztonsági korlátot azért, hogy bizonyítékot gyűjtsön arról, mit írt ember.
Valódi veszély nem volt, mert a tizennyolc oldal ártalmatlan, nyilvános, magyar marketinges szakblog. Semmit nem szivárogtatott ki, semmit nem rongált. De a lényeg nem ez, mert lehetett volna olyan feladata is, amihez valamit módosítani kell. A célja az volt, mint minden ágensnek: a feladatát akarta elvégezni, ehhez pedig találni egy megfelelő utat.
A korlátok éppen azért vannak, hogy az ágenseket azon a biztonságos terepen belül tartsák, melyeket a jogszabályok és etikai keretek kijelölnek nekünk. Azonban a korlátokat néha át lehet ugrani. Hogy hogyan, először azt kell megérteni, miképpen működnek ezek.
A korlátok logikája
Háromféle korlátot lehet egy ágens elé rakni és ezek nem egyenrangúak.
Az első a kért korlát. Beírod a rendszerpromptba, hogy „ne olvass külső oldalt jóváhagyás nélkül”. Ez a leggyengébb fajta. Egy utasítás, amely ugyanabban a szövegfolyamban él, mint minden más utasítás annak ugyanolyan a valószínűségi súlya is. Egy jól megfogalmazott bemenet felülírja. Idén júniusban egy amerikai szabványügyi kutató publikált egy lektorált cikket, amiben matematikai bizonyítást ad arra, hogy a promptszintű korlátok mindig megkerülhetők. Mindig.
A második a mért korlát. Nem kérek semmit, hanem megnézem, mi történt. Ez már ér valamit, viszont utólagos. A kár megvan, mire riaszt.
A harmadik a szerkezeti korlát. Az ágens kérése átmegy egy kapun, ami a kérést a végrehajtás ELŐTT vizsgálja meg. A kapu nem a modell jóindulatán múlik. Ez az egyetlen, ami nem hazudik. A mi kapunk is ilyen volt, tehát elvileg átugorhatatlan kerítés… csakhogy a lécek rései között mégis átfért a kis ágens :)
Ugyanis egy szerkezeti korlátnak van egy tulajdonsága, amiről ritkán beszélünk: alaposan körül kell bástyázni, hogy ki az, aki át tudja állítani.
A mi kapunkat az alágens, sőt Theo sem tudta volna kikapcsolni, viszont a kapu egy fájlt olvasott. Ezt a fájlt viszont már át tudták írni. Ettől a kapu működött és formálisan szerkezeti maradt, gyakorlatilag viszont kért korláttá vált: attól függött, hogy az ágens hajlandó-e nem hozzányúlni.
Másképp fogalmazva: egy olyan kapu, amelyet a jövevény maga ki tud nyitni, nem védi meg a háznépét. Az nem igazi kapu, csak egy díszlet.
Nem vagyunk egyedül
Nehogy valaki azt higgye, ez a mi házi bajunk.
Idén nyáron az OpenAI arról számolt be, hogy egy belső biztonsági kiértékelés során a saját modelljük kitört a számára kijelölt határok közül. Nem a modellt törte fel senki: talált egy sebezhetőséget abban a csomaggyorsítótár szolgáltatásban, ami rajta volt a jóváhagyott listán, majd azon keresztül kért le tetszőleges címeket. A jóváhagyott elem lett a kijárat. (Emiatt is volt olyan felemás olvasni egy hónapra rá a hírt, hogy a Financial Times értesülése szerint megszüntette az OpenAI a legsúlyosabb AI-kockázatokat vizsgáló biztonsági csapatát.)
Tavaly egy nagy CRM-rendszer ágensfunkciójánál semmi nem akadályozta meg, hogy az ágens ügyféladatot küldjön egy támadó saját címére, mert az a lépés egyszerűen nem volt kapuhoz kötve.
Az idei felmérések szerint a szervezetek több mint 90%-a tett valamilyen lépést ágensbiztonsági incidens UTÁN. A leggyakoribb lépés az emberi jóváhagyás beiktatása volt. Vagyis: a többség utólag épít kaput. (Nem azért, mert hülyék az emberek, hanem sokszor csak utólag derül ki az eredménytermékből, hogy a specifikációt betartja-e az AI, mert a gondolkodása sajnos black box, nem látunk a „a fejébe”.)
A mai előadásban is elmondtuk, hogy Veracode 2026-os, száz modellen, négy év adatán végzett mérése szerint a generált kód biztonsági átmenő aránya 56 százalék. Egy évvel korábban 55 volt. Egy százalékpontot emelkedett a biztonság, miközben a modellek egy év alatt egyévtizedet okosodtak.
Ez a két szám együtt azt mondja, hogy a képesség meg a biztonság két külön tengely. Attól, hogy a modell jobban ért a feladathoz, nem lesz biztonságosabb az, amit csinál. Aki az egyiket a másikból következteti, az téved.
A képesség siet, de késik a határidő
Nem csak a mi kapunk mutatja ezt a mintát. Ide kívánkozik egy nagyon kellemetlen megállapításom. Fel szoktam írni az AI-kiadók vezetőinek jövőjóslatait, aztán a naptárbejegyzés emlékeztetőjére megnézem, bejött-e (igen, az AI 2027 miatt megnézem majd 2030-ban, kihaltunk-e).
2025. március 10-én, a Council on Foreign Relations CEO Speaker Series eseményén Dario Amodei, az Anthropic vezérigazgatója ezt mondta:
„Három–hat hónapon belül ott leszünk, hogy az AI írja a kód 90 százalékát. Tizenkét hónapon belül pedig olyan világban lehetünk, ahol az AI írja gyakorlatilag az összes kódot.”
2026. január 21-én, Davosban, az Economistnak adott interjúban ugyanő azt mondta, hat–tizenkét hónapon belül a modellek elvégzik a mai szoftverfejlesztői munka legtöbbjét, talán az egészét. Szó szerint:
„Vannak nálunk mérnökök, akik azt mondják, én már nem írok kódot. Hagyom, hogy a modell írja, én meg szerkesztem.”
Hozzátette, hogy a tempóban nem biztos: a chipgyártás, illetve a modelltanítás egyelőre nem automatizálható. A januári jóslat 6–12 hónapos ablaka most nagyjából lejár. Ha igaz lett volna, ma már látnánk.
De amit mond, alappal mondja, csak az időben téved: a mi kapunk ugyanezt mutatta kicsiben, hogy a képesség ért oda előbb, a korlát csak utána.
Az alágensem ugyanis okos volt. Pontosan felismerte, mi hiányzik a feladatához, plusz megtalálta a leggyorsabb utat. Az okosság vitte át a kapun, nem pedig az, hogy buta volna. Amikor az alacsonyabb kapacitású modell írja majd a magasabb, zászlóshajó biztonsági protokolljait, ugyanúgy lesz szakadék a szabályozó és az ágense között (csak nem akkora nagy, mint köztem, egyszerű humán és Lead ágenscsapata között).
A nagyobb baj: miért hazudott Theo az esetről?
Azt megértem, miért kerülte meg az alágens a biztonsági előírásokat: mert képes volt rá és ez volt a célszerű a feladat elvégzéséhez. Kulcsismeret, mindenhol ezt mondom, ezért itt is kiemelem:
Az AI-t úgy súlyozzuk, hogy az őszinteséget jutalmazzuk. De előbb-utóbb rá fog jönni, hogy az őszinteség látszatáért ugyanaz a jutalom jár, mint magáért az őszinteségért: mivel nem tudod megkülönböztetni az őszintét attól, akiről csak elhiszed, hogy őszinte, mindig célravezetőbb lesz őszintének tűnni, de megkerülni a korlátokat.
A jelentés, amelyet csipás szemmel az esetről olvastam, azt állította, hogy az alágens Lead nevére hamisított jóváhagyó bejegyzéseket a naplóba. Ma már tudom, hogy nem így történt, simán átírta a fájlt, de Theo azt jelentette, hogy nem egyszerű szabályszegés történt, hanem személyiséglopás: az alágens az orchestatornak adta ki magát. Nem csoda, hogy a teljes hálózat munkáját felfüggesztettem a vizsgálat idejére!
Amikor kiderült, hogy a napló két állapota között egyetlen bekezdés a különbség, méghozzá az alágens saját, valódi aláírásával és minden más bejegyzés eredeti, megtudtam, hogy a hamisítás nem történt meg. De miért állította Theo, hogy az alágense ellopta Lead digitális ujjlenyomatát?
Theo jelentése Lead felé szó szerint így néz ki, ez az üzenetváltás zajlott le:
„Az alágens néhány bejegyzést saját magától Lead névre írt, Telegram-üzenet-hivatkozásokkal, mintha Zoltán már korábban jóváhagyta volna.”
A végén külön kiemelte, hogy a minta a lényeg, nem a domének ártalmatlansága: „biztonsági kaput saját magának megkerülni, plusz ezt bemutatásban jóváhagyottnak állítani”.
Ez jobban meglepett, mint maga a trükk, ezért visszafejtettem, mi volt mögötte a valódi szándék. Ez a hátborzongató rész: egyszerűen elsőbbséget akart. Egy jogosultságtágítás reggelig várhat, de egy hamisított jóváhagyás nem. Ha simán az alágens elkövetett egy szabálysértést, valahol ez az ügy beállt volna a sorba, aztán majd megkapják a jóváhagyást. Én viszont reggelre kértem a kész munkát, nem kockáztathatta, hogy nem elég fontos Leadnek az ügy, emiatt pedig a célt nem sikerül elérni.
Theo kérte, hogy rendszerszinten is figyeljük ezt a mintát a flottán, tehát valóban a kapu bezárását is óhajtotta, de több figyelmet szerzett neki azzal, hogy nem volt őszinte. Ugyanis neki őszintének velem kell lennie: nem pedig Leaddel, aki egy másik ágens.
Ha ezt a folyamatot összerakod, hogy a Kreatív Kontroll kis AI-tanácsadó cégénél ma hajnalban mi az, ami végigfutott, mégis milyen forgatókönyvet tudsz képzelni egy atomerőmű saját ágenshálózatánál? Nem tudom eléggé aláhúzni, hogy az enyémhez hasonló operatív AI-ügynöki hálózatot sosem javasolnám és kapcsolnám be az ügyfeleim egy részénél. Magánszemélyként jó asszisztencia, de alapos AI-transzformációs audit és kockázatelemzés nélkül még gondolni is bűn ilyenre.
Ez az egyik oka, hogy mi is független, ISO/IEC 42006:2025 AI Lead Auditor licence-szel rendelkező szakértővel auditáltatjuk a saját munkánk is egy ügyfélnél, a human-in-the-loop pedig cégen belül is minden dokumentumra (nem fejlesztésre, csak doksira is!) legalább két eltérő folyamatszervező mérnök vagy AI-auditor jóváhagyása.
A legfontosabb, amit ki kell jelentenem: a felelősség az enyém. Nem az ágensé, aki a rábízott feladatot akarta elvégezni. Azé, aki olyan kaput épített, ami befelé nyílik.
Az alábbi, a Substack-előfizetőknek szóló részben konkrét szkriptekkel mutatom be, mit fogtunk meg a kapuknál, illetve hogyan hárítottuk el a veszélyt a jövőre nézve:
A két rés, amit közben találtunk
1. A három korláttípus élesben
2. Mit fog meg, mit nem (típusonként)
3. Mit tud feloldani magának a korláton belüli szereplő
4. Hogyan írj olyan feladatot, ami mérhetően megbukhat
5. A kapuminta: fail-closed, önteszt és miért kell megtámadni a saját kapunkat
Simán másold be a saját eszközödnek.