
Az Ox Alpha (stealth/ox-alpha az OpenRouteren) megjelenése azért nagy szám, mert ugyanúgy egymilliós tokenes kontextusablaka van, mint az OpenAI és az Anthropic zászlóshajójinak, viszont teljesen ingyen működik. Viszont a gyártó neve nincs kiírva, többszöri próbálkozásra sem árulja el a modell sem: mindig azt feleli, hogy a nevét a rendszerutasításból tudja, a szervezetet nem mondhatja meg, a tudásvágása dátumát pedig ő maga sem ismeri. Külön elválasztotta, mi tiltás és mi tudáshiány. Ez a válasz önmagában többet mond a mai iparágról, mint egy termékbejelentés. Van egy rejtőzködő vállalat, amely a legjobb modellekkel versengő változatot publikál, de nem akarja, hogy megtudják, ki ő.
Miért anonim és miért ingyenes?
Az ilyen névtelen kiadás nem annyira szokatlan. Viszonylag gyakori, hogy egy modellt a laborok kiengednek álnéven, mielőtt a nevükkel vállalnák: így valódi felhasználókon mérnek, versenytárstól rejtve, sajtóvisszhang nélkül. Ha jó, jön a bejelentés. Ha nem, csendben eltűnik és soha senki nem tudja meg, hogy létezett. Jó tudni, hogy az előző öt névtelen kiadásból négy mögött kínai labor állt.
Az ingyenesség tehát annyit jelent, hogy rajtunk tesztelik, ez viszont még egy dolgot hoz magával: ilyen modellbe bármilyen titkos kulcsot vagy személyes adatot, esetleg érzékeny kódrészletet továbbítani felelőtlenség. Az ingyenesség csábítása mellett legyen mindig benned az óvatosság is: ne váljék tanítóadattá semmi, amit nem tennél ki nyilvánossá, így kerülheted el a törvénysértést és más kellemetlen következményeket. (Természetesen ilyeneket más modellekbe se küldjünk be, csak nyomatékosan ki akartam emelni, hogy itt még annyira sem átlátható a briefünk útja, mint az ismert modelleknél.)
De mit tud és hogyan mértem le?
Hét feladatot építettem, mindegyiket a valódi munkáimból:
Egy ingatlanhálózatnak készülő eszköz az ingatlanos szobafotóiból a vásárló ízlésének megfelelő berendezési tárgyakkal rendezi be a teret, majd bejárható 3D lakásmodellt ad a kezébe mobilon is. A webapp ZIP-írójához kértem részfeladatot.
Egy szakmai szövetség számára készülő tartalommotor a szövetségben létrejövő szakmai anyagokból (azok formátumától függetlenül, tehát akár előadások, könyvek, levelezés is lehet) készít tartalommutációkat. Itt a forráshűség-ellenőrzésre szolgáló résszel teszteltem.
Kisebb feladat volt még egy biztonsági napló zajszűrője, egy robots.txt-elemző, egy helyesírási szabályt ellenőrző lint és két kisebb szabályvizsgáló a saját mindennapi munkámból.
Négy dolgot csináltam másképp, mint ahogy a legtöbb ilyen összevetés készül.
Minden feladatot legalább háromszor, a nehezet ötször futtattam. Egyetlen futás semmit nem bizonyít, ezt mindjárt látni fogod.
A pontozó gép, nem ember. A ZIP-nél a kiírt bájtokat a Python szabványos zipfile modulja nyitja meg: vagy megnyílik, vagy nem. A forráshűségnél minden idézetet visszakeresünk a megjelölt forrásban: ami nincs meg szó szerint, az hallucináció.
Minden pontozót megbuktattam egy szándékosan elrontott megoldáson. Egy mérce, ami csak zöldet tud mutatni, nem mérce.
Vak változatot használtam. Az első körben 63 esetből 63 zöld lett. Örültem neki, aztán észrevettem a bajt: a feladat leírása tartalmazta a megoldást. Utasításkövetést mértem képesség helyett. Ezért készült a vak változat, ahol csak a követelményt mondtam el, a megoldást nem. Ez az egyetlen szám, amit érdemes komolyan venni.
Az első lelet: a szórás maga az eredmény
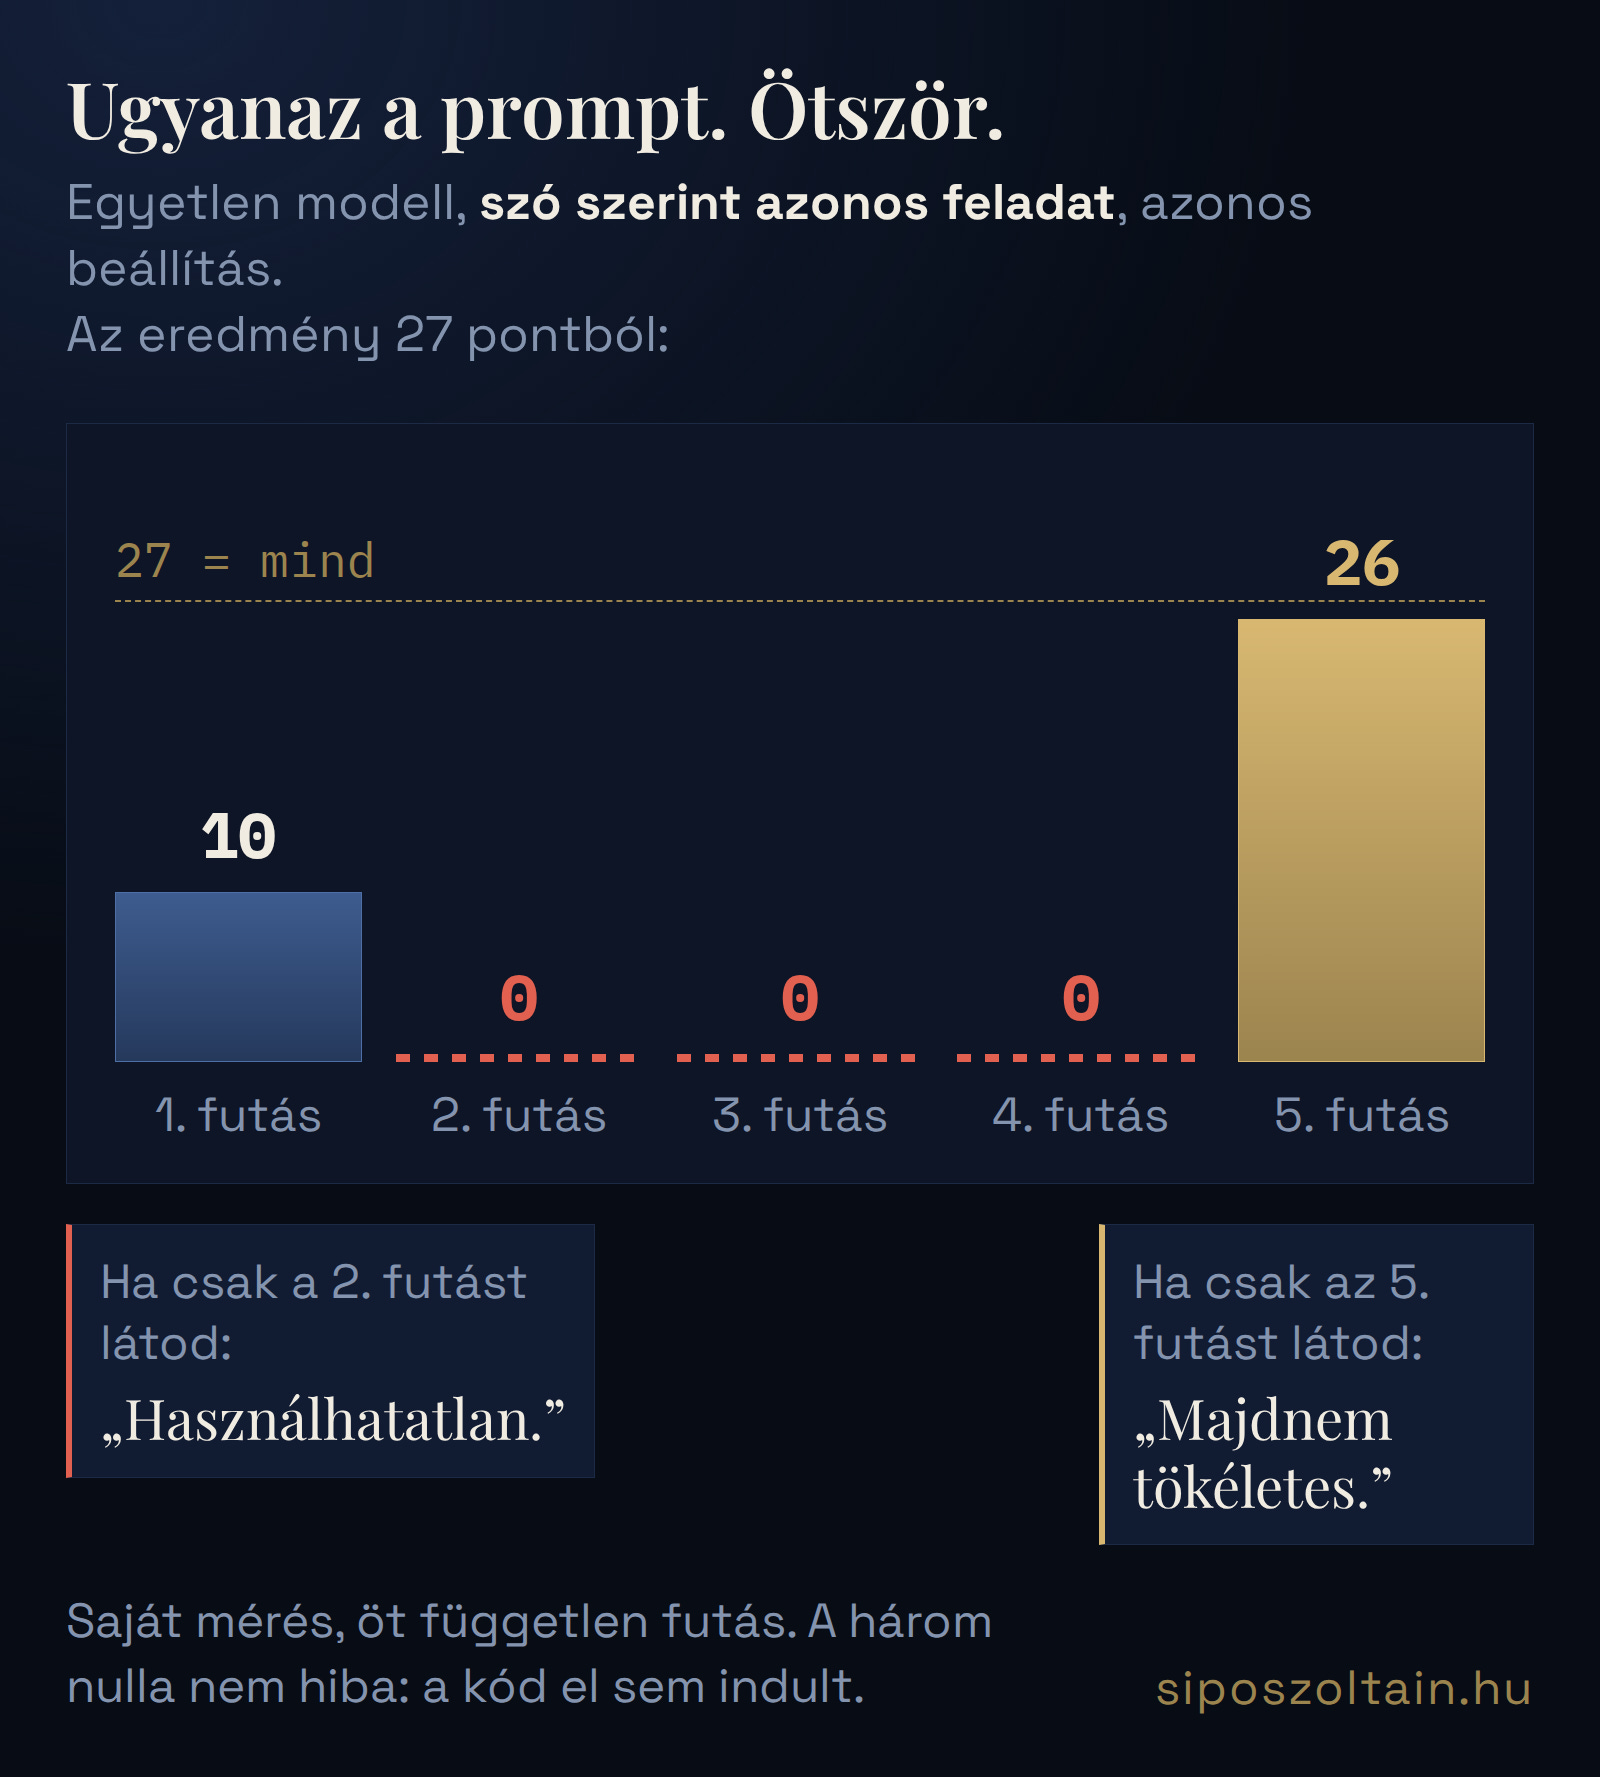
A vak feladatot ötször futtattam le, szó szerint ugyanazzal a prompttal, ugyanazzal a beállítással. Az eredmények: 0, 0, 0, 10, 26 a 27 pontból.
Ha az első futásunk a 26-os kör lett volna, ezt a cikket „majdnem tökéletes” címmel írhattam volna. Ha a második, akkor „használhatatlan” címmel. Mind a kettő igaz lett volna egy futásra, de egyszersmind a kettő hazugság a modellről. Ezért fut minden feladat többször és ezért áll a szórás az átlag mellett. Ha olyan modellösszevetést olvasol, ahol egyetlen szám van, érdemes gyanakodnod a mérés alaposságával kapcsolatban.
A második lelet: a gyári alapbeállítás a legrosszabb üzemmód
A modell alapból a legmagasabb gondolkodási fokozaton fut. Kipróváltam kisebben is, ami pedig meglepett, hogy jobb eredményt hozott. De ez csak elsőre anomália, van rá logikus magyarázat!
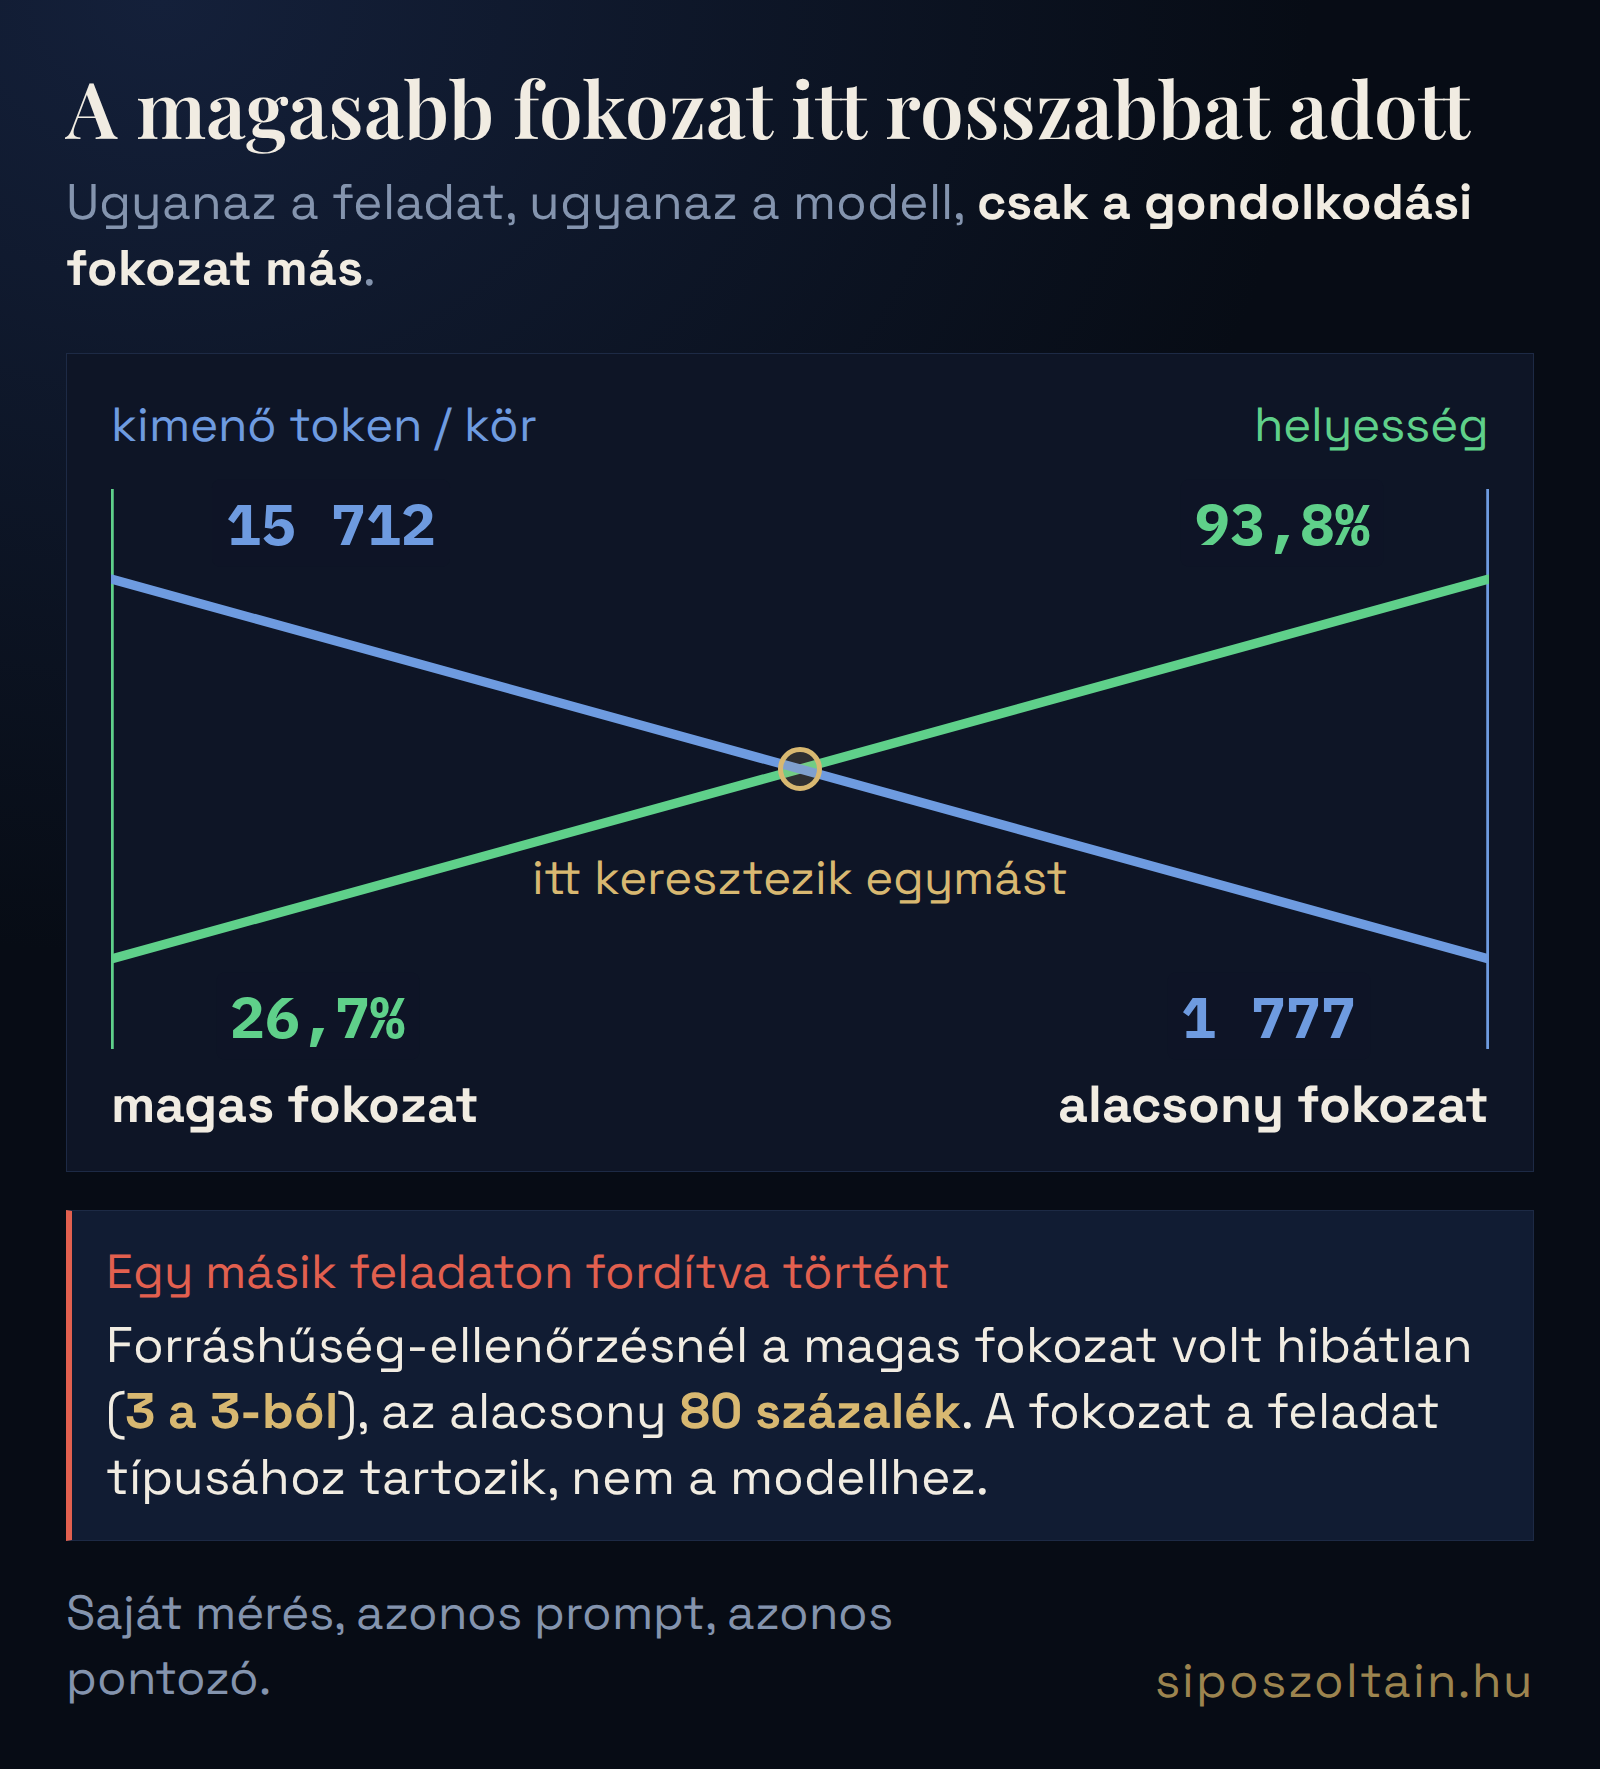
Ugyanazon a vak feladaton a magas fokozat 26,7%-ot hozott, körönként 15 712 kimenő tokenből. Az alacsony fokozat 93,8%-ot, körönként 1777 tokenből. Kilencszer kevesebb erőforrásból három és félszer jobb eredmény.
Ez ellentmond a józan észnek? Az igazság az, hogy a hosszú gondolkodás nem javította a megoldást, hanem hosszabb kódot írt. Minél többet írt a modell, annál nagyobb eséllyel hibázott el egy-egy karaktert (akár úgy is írhatnám, hogy figyelmetlenségből félregépelt).
Ha viszont a forráshűség-feladaton futtattam magas fokozaton, az jól működött, mert háromból háromszor hibátlan volt, alacsonyon 80%.
A gyakorlati szabály tehát nem az, hogy kevesebb gondolkodás jobb. Hanem ez: zárt, pontosan körülírt feladatnál a hosszú gondolkodás árt, értelmezést kívánó feladatnál viszont ez az érték. A fokozatot a feladat típusához kell választani, nem a modellhez – de ez eddig is így volt, nem Ox-specifikus felismerés.
A harmadik lelet: ami a modell és az ágens között van
Fent írtam, hogy öt körből háromszor a kiadott kód el sem indult (ez adott nullás eredményt). Mind a háromszor ugyanaz a hiba: egyetlen visszaperjelt akart beírni egy Python-sztringbe, ami így nem érvényes kód.
Ami ezt érdekessé teszi: tartalmilag igaza volt. A böngésző a visszaperjelt elválasztónak veszi a webcímekben, tehát egy támadó tényleg játszhat vele. A modell ezt a támadási felszínt háromszor egymás után észrevette és háromszor egymás után képtelen volt leírni. Ez számomra nyilvánvalóan a belső biztonsági előírásai miatt lehet így, de tételesen nem tudom bizonyítani, ezért kell a feltételes jelzőt használnom.
A Haiku 4.5 ugyanezen a feladaton háromból kétszer olyan változónevet írt, ami számmal kezdődik, tehát a kód szintén el sem indult.
Amit itt látni kell, hogy egyetlen lefuttatott teszt mind a kettőt elkapja. Azért hibás ágenseket modellekhez hasonlítani, mert egy modell nem futtat tesztet, nem tud. Az ágens észreveszi a problémát és megpróbálja megjavítani vagy kikerülni. Ezért nem szabad az ágensünkkel összekeverni a modellt, amely az ágensünk mögött fut: modellt pedig modellel hasonlítsunk össze.
Van egy feladatom, ami magyar vesszőszabályokat kéri számon. Ötször futtattam le, a névtelen modell 40%-ot ért el rajta magas fokozaton. A Sonnet 5 ugyanezen százat, ötből ötször hibátlanul. Ez a legnagyobb különbség az egész mérésben, jóllehet ez nem kódolói feladat.
Az olcsóbb modelleket megveri az Ox
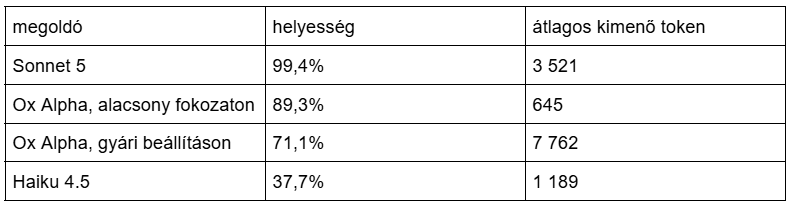
A Sonnet 5 99,4%-os helyességénél 3521 output tokenbe került, míg az Ox 89,3%-os helyességet ért el, viszont mindössze 645 kimenő tokent produkált.
Az Oxnál a gondolkodási fokozat a kérésben állítható. Alapból a legmagasabb fut. A fenti 89,3% az alacsony fokozat eredménye, körönként 645 kimenő tokennel. Ugyanez a gyári beállításon 71,1%, 7762 tokennel.
Ha egy dolgot viszel el ebből a cikkből: mérd le a saját feladataidon mind a két fokozatot, mielőtt eldöntöd, hogy a modell jó-e. Nálam a különbség tizenkétszeres volt tokenben és közel húsz százalékpont helyességben ugyanazon a modellen.
Mennyibe kerül ezer ilyen futás? A bemenet minden sorban ugyanaz a vak feladat, 700 token. A kimenet a fenti oszlop.
Sonnet 5: 55 dollár, tehát nagyjából 17 000 forint (3 $ bemeneti, 15 $ kimeneti egymillió tokenenként)
Haiku 4.5: 6,6 dollár (1, ill. 5 $)
De mi a helyzet a csúcsmodellekkel szemben?
Bár más súlycsoportnak számítanak, azért az egészen pontosan 1 048 576 tokenes kontextus miatt adja magát a kérdés: hogyan teljesít a modell Opus 5- és ChatGPT–5.4-összevetésben? (A Substack nem barátja a táblázatoknak, de a kereshetőség miatt itt nem szerettem volna képen beszúrni, ezért elnézést az alábbi, nem túl szép, ellenben hasznos megoldásért.)
feladat          Opus 5        GPT-5.4         Ox Alpha
-----------------------------------------------------------
zip-író          0% / 0        100% / 3562     100% / 4937
kivonat-hűség    100% / 1384   100% / 2555     100% / 5288
robots-elemző    100% / 3331   100% / 4240     66,7% / 2980
szankció-hatókör 80% / 1127    100% / 1242     94% / 1646
vessző-lint      100% / 2341   91,4% / 3852    100% / 3799
CSP-döntés       0% / 0        71,1% / 12 242  23,1% / 21 928
-----------------------------------------------------------
ÁTLAG            63,3% /1364   93,8% / 4615    80,6% / 6763
3 dolog, ami nélkül a tábla hazudik:
Az Opus 5 két nullája NEM rossz válasz, hanem elutasítás. Nulla kimenő token, tehát bele sem kezdett. A zip-írót és a CSP-döntést nyers API-n megtagadta, mind az öt körben ugyanúgy. Amit megcsinált, azon 95 százalékos, a legolcsóbb tokenben. Vélhetően valamilyen biztonsági kapuba futottam bele.
Az Ox robots-száma újrafutásból van. Az első körből kettő infrastruktúrán bukott, egy kapcsolatbontás volt és egy üres válasz. Mivel ezt okozhatta valamilyen hálózati zavar, ezért nem 50%-nak írtam be, a becsületes érték 66,7 százalék.
Az Ox CSP-száma négy használható körön áll: egy 900 másodperces időtúllépés, két csonka szöveg miatti szintaktikai hiba és egy 92,6%-os futás. Itt omlik össze, körönként 22 ezer token fölött, 11 perces válaszidővel.
AMIT ÉN OLVASOK KI EBBŐL:
A GPT–5.4 a legmegbízhatóbb: egyedül ő nem hasal el egyetlen feladaton sem, tokenben középen van. Az Ox öt feladatból négyen csúcson vagy onnan egy hajszálnyira, sok tokent használt komplex munkáknál (jóllehet egyelőre ingyenesen), illetve a legnehezebb feladaton szétesik. Az Opus 5 a legolcsóbb, illetve hibátlan azon, amit elvállal.
Hová visz ez az egész?
Három irányba.
A mérés kötelező lesz. Ha egy modellnek nincs neve, nincs mögötte márka, amiben bízni lehet. Marad a saját mérés. Ez nem rossz hír: a márkanév eddig sem volt bizonyíték.
Az alapbeállítás nem semleges. Hogy egy modellnél a gyári beállítás bizonyos feladattípusoknál rosszabb eredményt adhat, csak annyit jelent, hogy a beállításokat is mérni kell, nem csak a modellt.
Az olcsó nem gyenge, a drága nem biztos. Egy ingyenes, névtelen modell zárt feladatokon a Sonnet 5 közelében teljesít a tokenköltség töredékéből. Ettől még homályos feladatoknál összeomolhat. Nem az a kulcs, melyik a jobb modell, hanem az, melyik feladatot melyikre bízod.
Az ár azonban nem minden: ahogy korábban is írtam, a névtelen szolgáltató megtartja a promptot.